Dokumentenverwaltung mit Paperless-ngx

Nachdem ich auf Mastodon ein Posting hinterlassen hatte, in welchem ich mit „meinem kleinen Dokumentenscanner“ angegeben habe, wurde unter anderem die Hoffnung auf einen Artikel zum Thema an mich herangetragen. Ich habe also einen geschrieben…
Digitaler Nachlass
… und ihn zum Anlass genommen, im Blog das neue Tag „Digitaler Nachlass“ einzuführen - ein Thema, das mich seit Monaten schon umtreibt und dem ich jetzt auch hier ein Gesicht geben möchte. Denn sollte ich mich in einem nicht ansprechbaren Zustand (oder schlimmer) befinden, müssen meine Hinterbliebenen sich irgendwie durch meine Angelegenheiten wühlen; und meine Dokumentensammlung ist ein durchaus relevanter Part meiner Angelegenheiten.
Ich weiß – das Thema ist total unangenehm. Es ist furchtbar, und niemand will ernsthaft darüber nachdenken. Für einige hat es was von einem schlechten Omen: Als würde man Unglück-Krankheit-Tod geradezu herausfordern, sobald man seine Angelegenheiten regelt.
Es wird uns aber alle betreffen, irgendwann und auf irgendeine Art. Nachlassverwaltung ist eine schmerzhafte und furchtbare Sache, sowieso; kommen allerdings technische Hürden, TouchIDs, FaceIDs, Keys und Zugangsdaten und Passwörter und Verschlüsselungen ins Spiel, macht das nichts besser.
Ich empfinde meinen Lieben gegenüber eine große Verantwortung, ihren Schmerz an der Stelle so gering zu halten, wie ich nur kann. Und ich möchte, dass es ein Thema wird: Dass wir darüber reden, wie es gut funktionieren kann, Ideen austauschen, uns gegenseitig auf eventuelle Stolpersteine hinweisen. Und ich sehe uns „Techies“ in der Pflicht, die Nicht-Techies gerade auch in dieser Sache ein Stück weit zu begleiten, zu beraten, zu unterstützen.
Ursprünglich habe ich meine Dokumente ganz oldschool in Ordner einsortiert; und auch da nur das, was sich automatisch ergab. Über die Zeit stellte sich heraus, dass das für mich zwei Schwachstellen aufweist. Die erste war, dass sich mit der Zeit immer weniger „automatisch ergab“: Rechnungen kamen nicht mehr per Post, sondern in Form eines PDF per E-Mail herangeflattert (oder, schlimmer noch, sie schlummerten plötzlich in den Kundencentern der diversen Anbieter).
Der zweite Punkt bestand darin, dass die Aufbewahrungspflicht von Patientenunterlagen mit ein paar Ausnahmen lediglich 10 Jahre beträgt; nach Ablauf dieser Zeit kann man sich bei Kliniken und Ärzten keine Ausdrucke vergangener Konsultationen mehr holen. Und wenn man wie ich mit multiplen gesundheitlichen Fallgruben zu tun hat, kann das zum Problem werden – man ist gut damit beraten, sich ein persönliches Archiv aller Arztbriefe und Befunde anzulegen.
Das also war meine Ziele:
- alle relevanten Datenbestände zusammenführen – unter meiner Hoheit und im direkten Zugriff
- Papierdokumente digitalisieren und sie somit leichter (und im Zweifel auch von unterwegs, Stichwort „Zweitwohnsitz“) durchsuchbar machen
- ein Archiv meiner ärztlichen Unterlagen erstellen
- neben der üblichen Backup-Prozedur auch für ein externes verschlüsseltes externes (dokumentiertes!) Backup sorgen, so dass zumindest die digitalen Versionen aller relevanten Dokumente erhalten und zugreifbar bleiben, sollten Feuer-Wasser-Sturm die Originale dahinraffen
- nicht mehr Ordner und Zettelschublade wälzen müssen, wenn ich etwas suche (und darüber verzweifeln, weil meine Was-lege-ich-wo-ab-Logik zwar immer irgendwie logisch, aber über knapp drei Jahrzehnte nicht unbedingt konsistent war) - zum Beispiel, wenn ich schlagartig Garantieansprüche geltend machen muss
- unkompliziert alles für die Steuererklärung vorbereiten können
- Überblick behalten über bezogene Gesundheitsleistungen (AKA „Wann hatte ich eigentlich die letzten Kompressionsstrümpfe?“ oder „Von wann war nochmal die Bildschirmarbeitsplatzbrille?“), um weder Ansprüche verstreichen zu lassen, noch aus Versehen etwas zu häufig zu beantragen
Ich habe nach einer Lösung gesucht, die mich im Alltag unterstützt und nicht nervt – denn nur dann gibt es eine Chance, dass ich sie auch dauerhaft mit Informationen füttern werde. Deshalb verzichte ich auf technisches Gebastel, das ich nach Upgrades aufwendig reparieren müsste, und keepe es möglichst simple and stupid.
Paperless-ngx im Container
Ich habe mir Paperless-ngx sozusagen „hingedockert“; dabei habe ich mich an den Informationen auf Docker Hub beziehungsweise GitHub orientiert. Exemplarisch:
docker-compose.yml, um Paperless-ngx lokal zu betreibenservices:
broker:
image: docker.io/library/redis:8
restart: unless-stopped
volumes:
- redisdata:/data
db:
image: docker.io/library/mariadb:12
restart: unless-stopped
volumes:
- ./dbdata:/var/lib/mysql
environment:
MARIADB_HOST: paperless
MARIADB_DATABASE: paperless
MARIADB_USER: paperless
MARIADB_PASSWORD: paperless
MARIADB_ROOT_PASSWORD: paperless
webserver:
image: ghcr.io/paperless-ngx/paperless-ngx:2.20
restart: unless-stopped
depends_on:
- db
- broker
ports:
- "8000:8000"
volumes:
- ./data:/usr/src/paperless/data
- ./media:/usr/src/paperless/media
- ./export:/usr/src/paperless/export
- ./consume:/usr/src/paperless/consume
env_file: docker-compose.env
environment:
PAPERLESS_REDIS: redis://broker:6379
PAPERLESS_DBENGINE: mariadb
PAPERLESS_DBHOST: db
PAPERLESS_DBUSER: paperless # only needed if non-default username
PAPERLESS_DBPASS: paperless # only needed if non-default password
PAPERLESS_DBPORT: 3306
volumes:
data:
media:
dbdata:
redisdata:
In den ersten Wochen und Monaten habe ich dann alles in hineingeworfen, was mir ohnehin digital zugeht: Die Rechnungen für Festnetz und Mobilfunk, Rechnungen vom Hoster und von Software-Abos, viele Rechnungen von Online-Shops etc. Dazu meine Handarbeitsanleitungen, Notenblätter, die Anleitungen meiner Elektrogeräte (!), die eine oder andere Notizsammlung… Es kommt schon einiges zusammen.
Was mir wichtig war: An diesem Punkt hatte ich lediglich Zeit investiert, jedoch (noch) kein Geld. Ich wollte, erst einmal ganz für mich allein, prüfen:
- Komme ich zurecht mit Paperless-ngx?
- Mag ich die Arbeit damit?
- Wieviel Zeit kostet sie mich?
Ich wollte ein Gefühl dafür entwickeln, ob ich dieses Stück Software in meinem Alltag haben wollte - und das mit minimalem Kostenaufwand.
Ich endete mit einem bunten Strauß an Dokumenten, aufsteigend nummeriert, die über das Webinterface zugegebenermaßen schon gut durchsuchbar beziehungsweise auffindbar waren. Auf der Festplatte hingegen befand sich nun ein einzelner Ordner mit über 400 PDFs, die alle einen dummen Namen hatten - ohne das Webinterface wäre ich also (nicht ganz, aber fast) verloren.
Das hat mich noch nicht so ganz abgeholt.
Sort like nobody’s watching you!
An der Stelle etablierte ich „Storage Paths“, ein echter Game Changer: Mit ihrer Hilfe lässt sich auf der Festplatte eine Verzeichnisstruktur abbilden, in der ich mich notfalls auch ohne das Webinterface zurechtfinde.
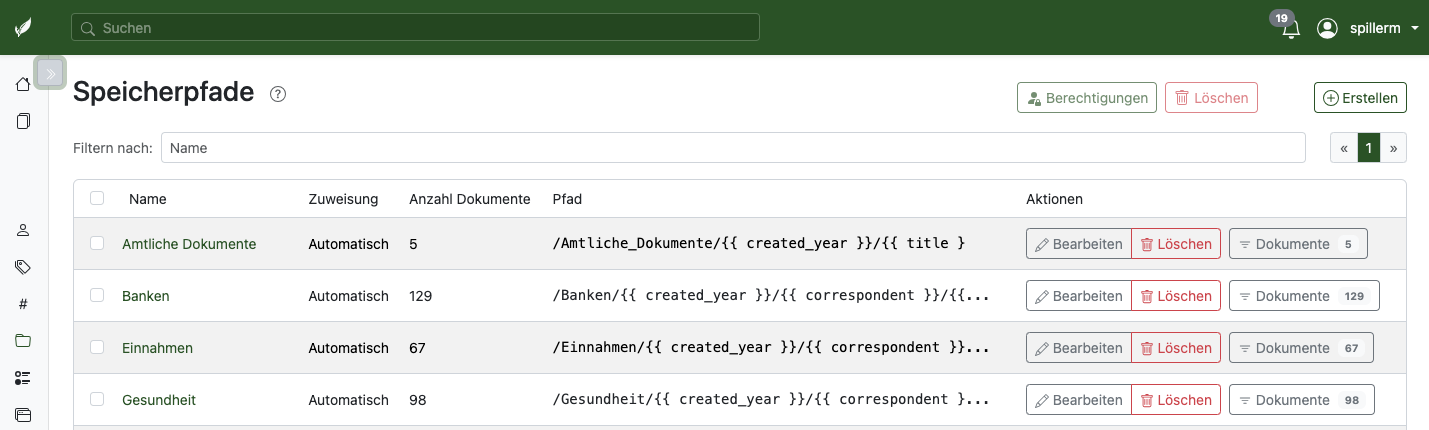 Speicherpfade in Paperless-ngx
Mit Hilfe der Platzhalter kann ich mir eine Struktur nach meinen Vorstellungen zimmern. Und was mir persönlich am besten gefällt: Diese Struktur lässt sich auch nachträglich sehr leicht ändern und anpassen. Stelle ich fest, dass anders irgendwie besser wäre, ändere ich meine Speicherpfade entsprechend. Die Änderung wird sofort übernommen, alle Dokumente liegen dann am neuen Ort - und das ganz ohne manuelle Intervention auf der Konsole.
Ich hab jetzt eine ganze Weile versucht, einen griffigen Screenshot davon zu machen; allerdings habe ich keinen gefunden, der nicht ein Zuviel an Information bereitgestellt hätte. Und der Versuch, relevante Punkte unkenntlich zu machen, resultierte in einem überwiegend unkenntlichen Screenshot. Deshalb seht es mir bitte nach: Ich lasse das lieber.
Diese Einfachheit, Dinge auch nachträglich ändern zu können, hat mich letztendlich überzeugt, Paperless-ngx fest zu etablieren. Und sie motiviert mich zu einer Ermunterung: Mach einfach!
Geh ganz ab von irgendwelchen Perfektionsgedanken. Du machst das Ganze im ersten Schritt primär für dich, Kategorien und Tags wie „Gesundheitsdingens“ oder „Haushaltsgedöns“ sind deshalb völlig in Ordnung. Vielleicht temporär, und du änderst sie, wenn dir passendere Bezeichner einfallen; oder im Zweifel auch dauerhaft, wenn du damit sinnvoll arbeiten kannst.
Einfach ist gut!
Aus meiner Erfahrung heraus empfehle ich, alles – Tags, Speicherpfade etc. – möglichst unkompliziert zu halten. Gerade wenn man ein Projekt beginnt, ist man gerne enthusiastisch bei der Sache, möchte es durchspielen, geht alles ein bisschen verkopft an; man beschäftigt sich regelmäßig damit, und das Thema ist präsent in allen Gehirnwindungen.
Dann kehrt ein wenig Ruhe ein; STAGE geht sozusagen in PROD über, und nun heißt es, die Sache mit Kontinuität weiterzuführen. Nach ein paar Wochen und weniger regelmäßiger Beschäftigung mit dem Thema sind komplizierte Tag-Verschachtelungen und siebzig verschiedene Speicherpfade aber nicht mehr in den Gehirnwindungen präsent und müssen gegebenenfalls erst nachgeschlagen werden - das ist dann die Stelle, an der es lästig wird.
Over-Engineering kann einer der leisen Killer sein, der dazu führt, dass ein Projekt verwaist. Im konkreten Fall: Dass du eben irgendwann keine Dokumente mehr einpflegst. Versuch deshalb, das zu vermeiden.
Import über den consume-Ordner
Dinge, die in den consume-Ordner gelangen, werden von Paperless-ngx automatisch aufgenommen und verwertet. Der Dokumentenscanner zum Beispiel, zu dem wir gleich noch kommen, legt seine Scans in diesem Ordner ab. Auch die App „Less Paper“ tut das. Und arbeite ich am Rechner und möchte etwas in Paperless-ngx speichern, gehe ich auch nur noch sehr selten über den Uploader im Webfrontend - der Weg über den consume-Ordner ist mir ungleich lieber.
Damit das so funktioniert, musste ich die Datei docker-compose.env um die Zeile PAPERLESS_CONSUMER_POLLING=60 erweitern und die Container neu starten.
Die Arbeitsabläufe
Ich habe mir überlegt, welche Arten von Dokumenten ich überhaupt so habe und ablegen wollen würde. Ich ich kam zu dem Schluss, dass es eigentlich nur zwei Arten sind: Die, die ich immer schon schön sortiert in Ordner gesteckt habe (und mit den Papierversionen würde ich das auch brav weiterhin zu halten, parallel zur Digitalisierung); und die „Zettelschublade“, Kassenzettel, Kleinkram. Ich überlegte mir, wie ich mit ihnen verfahren wollen würde – und wie sie ihren Weg in Paperless-ngx hinein finden sollten.
Arbeitsablauf I: Geordnete Dokumente
Folgendermaßen verfahre ich mit Dokumenten, die ich ganz erwachsen und ordentlich sortiert auch in physische Ordner ablege: Zum Beispiel solche von Ärzten, Lohnzettel, Arbeitszeugnisse etc.
- ich scanne ein Dokument, indem ich es in den Scanner lege und die Schnellwahltaste drücke
- die ist so belegt, dass der Scanner anhand meiner Einstellungen scannt, leere Seiten verwirft und das gescannte Dokument auf einem SMB-Share ablegt
- bei diesem SMB-Share handelt es sich um den
consume-Ordner von Paperless-ngx: Das Dokument wird automatisch in Paperless-ngx eingelesen und verarbeitet - dabei erhält es von mir automatisiert das Tag “Neues Dokument”
- alle Schaltjahre logge ich mich ins Webfrontend von Paperless-ngx ein
- dort filtere ich meine Dokumente nach dem Tag “Neues Dokument”, sortiere sie nebenher ein und entferne in dem Zuge dieses Tag
- ich entscheide jeweils, ob ich das Bool-Feld „steuerrelevant“ auf
truesetze - ich drehe auch PDFs, falls es nötig sein sollte, beziehungsweise verwerfe hier gescannte Seiten, die ich doch nicht haben möchte
- mit der Zeit wird Paperless-ngx auch immer treffsicherer darin, viele der Felder schon von selbst sinnvoll auszufüllen
- ich habe allerdings immer ein Auge drauf, dass für jedes Dokument das korrekte Datum hinterlegt wird
Arbeitsablauf II: Die Zettelschublade
Und so verfahre ich mit der „Zettelschublade“ – seien wir doch ehrlich, jeder hat eine Zettelschublade 😂 Kassenzettel, Fitzel, dieses schräge Zeug, das sich irgendwie nicht eindeutig zuordnen lässt… Das Bösartige an heutigen Kassenzetteln ist, dass diese so verbreitet auf Thermopapier gedruckt sind und beim kleinsten Anflug von $UMWELTEINFLUSS sofort unleserlich werden - schon allein deshalb lohnt sich die Digitalisierung. Und sei es nur, falls man irgendwo mal Garantieansprüche geltend machen muss.
- ich verpasse dem zu scannenden Dokument mit dem Paginierstempel eine laufende Nummer
- für Kassenzettel habe ich mir eine eigene Schnellwahltaste (Papierformat „Long Narrow“) angelegt
- wenn die Stempeltinte trocken ist, scanne ich das Dokument, indem ich auch hier über eine der Schnellwahltasten gehe
- wiederum landet das Dokument im SMB-Share, wird von Paperless-ngx automatisch gefressen, einsortiert und als „Neues Dokument“ getagged
- wenn ich sortiere, entferne ich dieses Tag, korrigiere ggf. das Datum und stelle sicher, dass ich unter „Archiv-Seriennummer“ die aufgestempelte Nummer eintrage
- ich entscheide auch hier jeweils, ob ich das Bool-Feld „steuerrelevant“ auf
truesetze - diese Zettel hefte ich anhand der aufgestempelten Nummer in aufsteigender Reihenfolge in einen physischen Ordner
- die Ordner beschrifte ich anhand der Stempelnummern, die sie beinhalten (1-1000 z.B.)
- brauche ich einen bestimmten, suche ich in Paperless-ngx über die Volltext-Suche, erhalte dort die Stempelnummer und weiß somit, wo ich nachschlagen (und nicht mehr: in der Schublade wühlen, anschließend die gesamte Bude auf den Kopf stellen und schließlich frustriert aufgeben) muss
Arbeitsablauf III: Import via „Less Paper“
Manche Dokumente sind umständlich, weil ich vom Rechner aus durch ein paar brennende Reifen steigen muss, um sie herunterladen zu können. Der Lohnzettel beispielsweise wird über den Dienst bereitgestellt, den der Arbeitgeber einsetzt, und fällt aus einer Smartphone-App; Kontoauszüge fallen aus der Banking-App, ebenfalls auf dem Smartphone. Damit ich diese mit möglichst überschaubarem Aufwand in Paperless-ngx stecken kann, habe ich (unter iOS) die App „Less Paper“ installiert. In der Banking App öffne ich dann meinen Kontoauszug, wähle „Teilen“, wähle dann „Less Paper“ aus und bestätige sofort mit „Import“. Ich bin zu faul, an der Stelle etwas auszufüllen – erstens erkennt Paperless-ngx vieles schon sehr zuverlässig inzwischen, zweitens mache ich sowas lieber am Rechner denn am Handy.
Von Zeit zu Zeit gehe ich übers Webfrontend von Paperless-ngx, filtere wiederum nach „Neues Dokument“ und sortiere auch diese Dokumente säuberlich ein.
Kauf von Hardware
Nachdem ich mir sicher war, dass das ein Weg ist, den ich dauerhaft gehen möchte, beschäftigte ich mich mit der Anschaffung unterstützender Hardware.
Der Scanner
Ohne Dokumentenscanner würde es nicht gehen. Also habe ich mich für einen Brother ADS-1800W entschieden; ich habe 279,- dafür bezahlt, was zu dem Zeitpunkt wohl ein recht fairer Preis war.
Es ist ein sehr kompaktes Gerät, erhält Strom via USB, hat WLAN, scannt sehr schnell und doppelseitig, verwirft leere Seiten (wenn man das denn möchte). Außerdem kann ich damit unkompliziert Karten scannen: Den Personalausweis, beispielsweise, den Führerschein oder Visitenkarten – das waren für mich so die wichtigsten Kriterien. Deine sehen da natürlich eventuell ganz anders aus.
Es gibt viele Sichtweisen, welche Hersteller zu bevorzugen sind; ich für mich kann sagen, dass auch der Anschaffungspreis eine Rolle spielte. Nutzt gerne die Kommentare, um euch auszutauschen und eure Erfahrungswerte dazulassen!
Der Paginierstempel
 Der Paginierstempel ist ein gewaltiges metallenes Ding, das genau eine Aufgabe hat: Eine fortlaufende Nummer zu stempeln. Und das tut er auch. Und zu meiner Zufriedenheit.
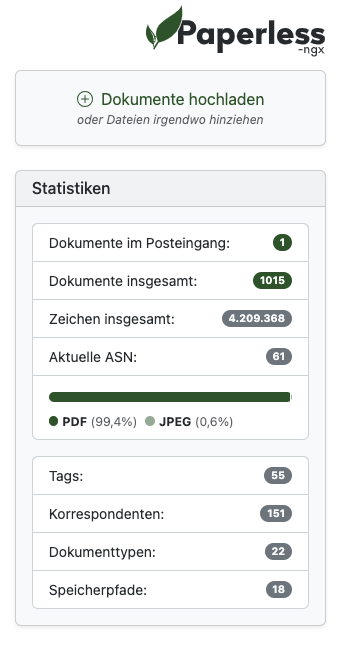
Wobei ich zugeben muss: Der hätte nicht zwingend sein müssen, ich hätte die Nummer auch von Hand auf die Zettel schreiben können. Paperless-ngx zeigt die nächste freie ASN (Archiv-Seriennummer) auf seiner Startseite an. Somit muss sich nicht der Stempel „merken“, welche die nächste freie Nummer ist. Aber was soll’s: Ich habe ihn, und dann nutze ich ihn jetzt natürlich auch.
Fazit
Wie du in dem Screenshot sehen kannst, umfasst mein Paperless-ngx aktuell 1015 Dokumente. Einige „Altlasten“ habe ich schon drin - zum Beispiel alle Arztberichte. Vieles, vieles fehlt noch, so beispielsweise Arbeitszeugnisse und -verträge, und es ist ganz natürlich, dass das so ist: Rom wurde auch nicht an einem Tag erbaut. Ich habe das im Hinterkopf und versuche, mit damit nicht verrückt zu machen: Es wird ein verregneter Samstag kommen, und dann jage ich eben mal wieder hundert Dokumente durch den Scanner.
Mich trösten dabei folgende Gedanken: Das initiale Erfassen der Altlasten dauert natürlich; das Erfassen von allem, was so reinkommt, läuft ja aber parallel. Will sagen: Irgendwann bin ich mit den Altlasten durch, und dann muss ich mich wirklich nur noch um „daily business“ kümmern.
Außerdem habe ich sofort merkbare Vorteile feststellen dürfen: Mal eben nachschlagen, wie die Modellbezeichnung des Scanners lautet, von welchem Hersteller das Paginiergerät war? Ich muss nicht überlegen, ob ich dazu in die Inbox schaue oder in der Zettelschublade wühlen muss – ich öffne ein neues Tab, suche in Paperless-ngx und erhalte in wenigen Sekunden die Antwort. Und alles läuft lokal, ich bin nicht auf externe Anbieter angewiesen. Ich habe meine Daten unter Kontrolle und im direkten Zugriff.
Auch wenn ich noch lange nicht „fertig“ bin: Schon jetzt wäre die Ausgangslage für meine Hinterbliebenen eine bessere als vorher; und mit jedem Dokument, das ich einpflege, wird sie noch ein bisschen besser. Dazu muss natürlich geregelt und dokumentiert sein, auf welchem Weg sie an die Daten gelangen können – an dem Punkt bin ich gerade.1
Ein Schrittchen nach dem anderen; immer in der Hoffnung, dass der Punkt, an dem das relevant wird, in weiter Ferne liegen möge.
Aber wer weiß das schon.
Einen sehr großartigen – und meiner Meinung nach überaus mutigen – Text zu diesem Thema und erlebten Stolperfallen findest du in diesem Artikel von Frank Neumann-Staude: „Alles ist gebackupt. Nur der Zugriff nicht.“. ↩︎
4 Kommentare
Von: Ekki
2026-06-15 15:20
Sehr hilfreich, gute Anregungen, danke.
Ja, sich mit dem eigenen digitalen Erbe auseinandersetzen zu müssen ist schmerzlich und lästig. Aber es hilft den Nachkommen ganz erheblich. Ich habe mich vor zwei Jahren um das Erbe meines Bruders gekümmert. Und da war der digitale Teil das Schwierigste, weil nichts organisiert war. Passworte hier und dort, Backups überall aber nicht systematisch, keine konsequente Ablage. So ein System hätte geholfen, wenn es den nachkommen denn dann zugänglich ist. Auch dafür muss man rechtzeitig sorgen.
Von: Martin
2026-06-15 16:02
Ich finde folgendes Addon für den Thunderbird sehr hilfreich:
https://github.com/sebastian-xyz/paperless-upload-thunderbird
Von: Frank Neumann-Staude
2026-06-18 13:19
Danke fürs erwähnen meines Beitrags. So mutig fand ich es überhaupt nicht. Ich habe im Krankenhaus und den Monaten danach festgestellt das kaum jemand das Thema Sepsis auf dem Schirm hat. Sobald ich wieder fit bin ( Ich habe tatsächlich heute, nach 5 1/2 Monaten endlich die Zusage zur Reha) wird es eine Veranstaltung zu dem Thema bei uns geben. Und das Feedback (das meisten per Mail oder IM ) zeigt mir, das der Beitrag richtig und wichtig war. Ich habe von vielen Menschen die Rückneldung, das sie nun endlich das eine oder andere an Vorsorge unternommen haben. Und damit hat der Beitrag vermutlich mehr erreicht als alle meine anderen - er hat Menschen zum handeln gebracht. Das freut mich sehr.
Liebe Grüße,
Frank Neumann-Staude
Von: Andreas
2026-07-11 10:58
Bei Anschaffung eines Scanners ist mir aufgefallen, dass Standalone-Scanner mit automatischem Dokumenteneinzug (ADF) z.T. ähnlich viel kosten wie ein Business-Tintenstrahler mit ADF-Scanner. Wer dann noch z.B. Zugriff auf Corporate Benefits oder ähnliche Angebote hat, kann da vielleicht preiswert einen Scanner mit "Bonus-Druckeinheit" erwerben. (Bei mir ist auf diese Weise ein Epson Workforce Pro eingezogen, der jetzt auch en passant als Kopierer verwendet wird. (Faxen könnte er auch noch, aber wir sind hier nicht im Kabarett!))
Hinterlasse einen Kommentar
Ich freue mich über jeden Kommentar, es sei denn, er ist blöd.
Deshalb sind die Kommentare auf dieser Seite auch generell moderiert.
Reaktionen aus dem Fediverse
Sofern du selbst einen ActivityPub-Account (wie beispielsweise Mastodon) nutzt, erscheinen auch deine Antworten auf mein Artikel-Announcement automatisch hier.